La velocità non è un dettaglio. È una dichiarazione di intenti.
Un sito lento dice a Google — e all’utente — che l’esperienza di chi lo visita non è una priorità. Un sito tecnicamente solido dice l’opposto: ogni millisecondo è stato considerato, ogni risorsa è stata ottimizzata, ogni interazione è stata progettata per essere fluida. Google ha deciso di premiare questa cura con un segnale di ranking diretto. Non è più una raccomandazione — è una metrica.
Il Technical SEO avanzato è la disciplina che trasforma l’infrastruttura di un sito da supporto passivo a vantaggio competitivo attivo. Non si tratta di correggere errori tecnici evidenti — meta tag mancanti, redirect rotti, pagine non indicizzate. Si tratta di costruire un’architettura in cui ogni componente tecnico lavora in sincronia per massimizzare la visibilità organica: velocità di caricamento, crawlabilità, renderizzazione, struttura dei dati, sicurezza, esperienza mobile.
Chi controlla il codice controlla il ranking. Chi affida il proprio sito a piattaforme chiuse negozia quel controllo con un intermediario che ha interessi diversi dai suoi.
Cosa leggerai
Cos’è il Technical SEO e perché è il fondamento di ogni altra ottimizzazione
Il Technical SEO è l’insieme delle ottimizzazioni che riguardano l’infrastruttura tecnica di un sito web — tutto ciò che sta sotto il contenuto e i link, ma che condiziona l’efficacia di entrambi.
La relazione tra Technical SEO e le altre discipline SEO è gerarchica: un sito con problemi tecnici gravi non beneficia pienamente dell’ottimizzazione dei contenuti, della costruzione di backlink o dell’architettura semantica. È come investire in un motore potente montato su un telaio danneggiato — la potenza non si traduce in prestazione.
Le aree del Technical SEO si dividono in tre macro-categorie:
Crawlabilità e indicizzazione: Google può trovare, scansionare e indicizzare correttamente tutte le pagine rilevanti del sito? Errori in questa area rendono invisibile il lavoro editoriale e di link building.
Renderizzazione e velocità: il browser — e il crawler di Google — riesce a caricare e processare le pagine in modo efficiente? I Core Web Vitals misurano esattamente questa dimensione.
Struttura e architettura: la gerarchia del sito è logica e navigabile? I segnali di autorità interni fluiscono correttamente verso le pagine prioritarie?
I Core Web Vitals: le tre metriche che Google ha trasformato in segnali di ranking
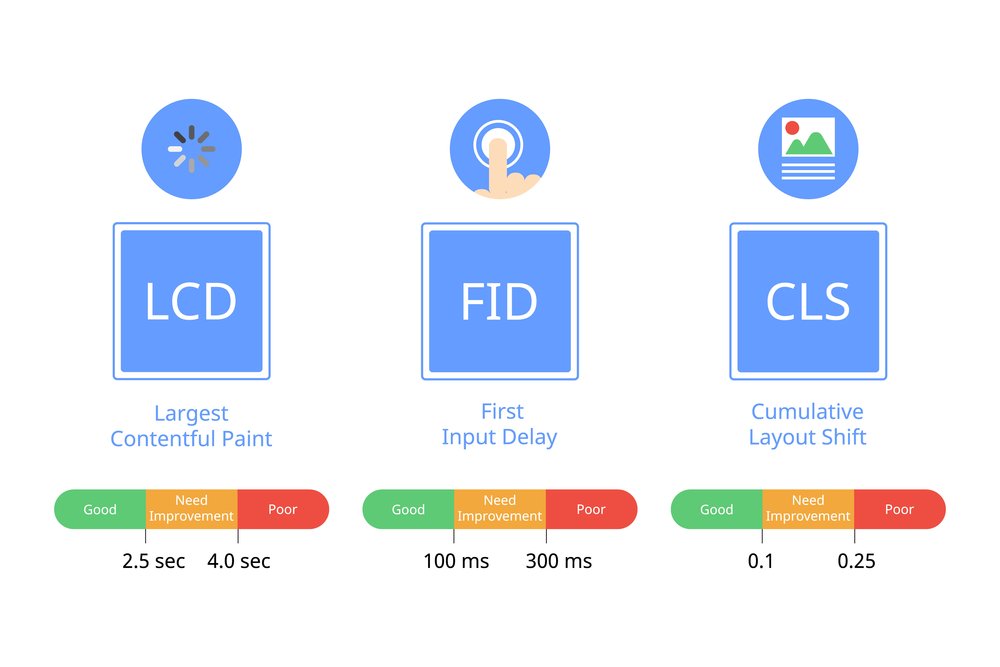
Nel maggio 2021, con il Page Experience Update, Google ha ufficializzato i Core Web Vitals come segnali diretti di ranking. Non sono metriche di laboratorio astratte: misurano l’esperienza reale degli utenti su tre dimensioni specifiche.
LCP — Largest Contentful Paint: la velocità percepita
L’LCP misura il tempo necessario perché l’elemento di contenuto più grande visibile nella viewport — tipicamente un’immagine hero, un blocco di testo principale o un video — venga completamente caricato e reso.
È la metrica che più si avvicina alla percezione soggettiva dell’utente: “quando ho capito che la pagina stava caricando qualcosa di utile?”
Soglie di valutazione:
- Buono: sotto 2,5 secondi
- Da migliorare: tra 2,5 e 4 secondi
- Scarso: oltre 4 secondi
Le cause più comuni di LCP lento:
Risorse bloccanti nel rendering: file CSS e JavaScript caricati in modo sincrono nell’<head> del documento bloccano il browser prima che possa iniziare a renderizzare il contenuto visibile. La soluzione è differire o caricare in modo asincrono le risorse non critiche per il rendering iniziale.
Immagini non ottimizzate: un’immagine hero da 3MB è la causa più frequente di LCP elevato. La soluzione passa per la compressione (formati WebP o AVIF), il dimensionamento corretto per il dispositivo (attributo srcset) e il precaricamento dell’immagine LCP con <link rel="preload">.
Server lento (TTFB elevato): se il Time To First Byte — il tempo prima che il browser riceva il primo byte di risposta dal server — è alto, tutto il resto è compromesso. Un TTFB accettabile è sotto 800ms. Le soluzioni includono hosting di qualità superiore, CDN, caching lato server e ottimizzazione delle query del database.
CSS render-blocking: fogli di stile di grandi dimensioni caricati in modo sincrono ritardano il rendering. La soluzione è estrarre il CSS critico — lo stile necessario per renderizzare il contenuto above the fold — e inserirlo inline nell’<head>, caricando il resto in modo differito.
INP — Interaction to Next Paint: la reattività alle interazioni
L’INP (che ha sostituito il FID — First Input Delay — da marzo 2024) misura la latenza di tutte le interazioni dell’utente con la pagina: click, tocchi, input da tastiera. Valuta il tempo tra l’azione dell’utente e la prossima visualizzazione aggiornata della pagina.
Soglie di valutazione:
- Buono: sotto 200 millisecondi
- Da migliorare: tra 200 e 500 millisecondi
- Scarso: oltre 500 millisecondi
Le cause principali di INP elevato:
JavaScript pesante sul main thread: il browser ha un singolo thread principale che gestisce sia il rendering che l’esecuzione di JavaScript. Script pesanti che occupano il main thread per lunghi periodi rendono la pagina non reattiva durante quella finestra. La soluzione è la suddivisione dei task lunghi in chunk più piccoli, l’utilizzo di Web Workers per operazioni computazionalmente intensive e il lazy loading degli script non necessari al caricamento iniziale.
Third-party scripts: widget di chat, pixel di tracciamento, script pubblicitari, player video esterni — ogni script di terze parti può impattare significativamente sull’INP. L’audit delle dipendenze di terze parti è spesso il primo intervento con il maggiore impatto sulla reattività.
Event listener non ottimizzati: listener attaccati a elementi del DOM che eseguono operazioni costose a ogni interazione possono degradare l’INP. Il debouncing e il throttling degli event handler sono tecniche di ottimizzazione specifiche per questo problema.
CLS — Cumulative Layout Shift: la stabilità visiva
Il CLS misura la quantità di spostamento inatteso del layout durante il ciclo di vita della pagina. È la metrica che quantifica quella frustrazione familiare: stai per cliccare un pulsante, il layout si sposta, e clicchi su qualcos’altro.
Soglie di valutazione:
- Buono: sotto 0,1
- Da migliorare: tra 0,1 e 0,25
- Scarso: oltre 0,25
Le cause principali di CLS elevato:
Immagini senza dimensioni dichiarate: se un’immagine non ha attributi width e height nel markup HTML, il browser non sa quanto spazio riservare prima che l’immagine venga caricata. Quando l’immagine arriva, spinge il contenuto sottostante verso il basso.
Annunci e embed dinamici: banner pubblicitari, widget di social network, video embed — tutti elementi che vengono iniettati nel DOM dopo il caricamento iniziale, causando spostamenti del layout.
Font personalizzati senza font-display: il caricamento di font web senza la direttiva font-display: swap o optional causa un FOUT (Flash Of Unstyled Text) o FOIT (Flash Of Invisible Text) che può generare layout shift quando il font custom sostituisce il fallback.
Animazioni e transizioni mal gestite: animazioni che modificano proprietà che influenzano il layout (width, height, margin, padding) invece di usare transform e opacity — che vengono gestite dal compositor thread senza impattare il layout.
Crawl budget: non sprecare le scansioni di Google
Il crawl budget è il numero di pagine che Googlebot scansiona su un sito in un determinato periodo. Non è infinito: Google alloca risorse di crawl in base all’autorità del dominio, alla velocità del server e alla qualità percepita del contenuto.
Per i siti di piccole e medie dimensioni, il crawl budget raramente è un problema critico. Diventa rilevante per gli e-commerce con cataloghi di migliaia di prodotti, per i siti di news con pubblicazione frequente e per qualsiasi sito che genera URL dinamiche in quantità elevata.
Ottimizzare il crawl budget significa due cose simultanee
Ridurre le scansioni inutili: URL generate dai filtri di navigazione, pagine di ricerca interna, URL con parametri di sessione o tracking, pagine di paginazione profonda — tutte queste URL consumano crawl budget senza produrre valore SEO. Si gestiscono con direttive noindex, con il blocco nel robots.txt o con tag canonici verso la versione prioritaria.
Concentrare le scansioni sulle pagine prioritarie: la struttura di link interni e la sitemap XML sono i meccanismi principali con cui si guida il crawler verso le pagine che meritano di essere aggiornate frequentemente nell’indice. Le pagine commerciali e le pagine pillar devono ricevere link interni da più punti del sito — non solo per il PageRank, ma per segnalare a Google che sono prioritarie per il crawl.
Robots.txt: lo strumento di controllo del crawl più diretto
Il file robots.txt è la dichiarazione delle regole di accesso per i crawler. Va gestito con precisione: bloccare directory intere quando si vuole bloccare solo certi pattern di URL è un errore grossolano che può penalizzare il crawl di pagine importanti.
Le direttive da conoscere:
Disallow: /ricerca-interna/ — blocca il crawler dall’accedere alle URL di ricerca interna Allow: /ricerca-interna/pagina-importante/ — sovrascrive il disallow per URL specifiche Crawl-delay: 1 — suggerisce un ritardo tra le richieste (non supportato da Googlebot, ma utile per altri crawler) Sitemap: https://esempio.com/sitemap.xml — dichiara la posizione della sitemap
Sitemap XML: la mappa che guida il crawler
La sitemap XML non è un obbligo tecnico — Google trova i contenuti anche senza di essa attraverso il crawl. È però lo strumento più diretto per segnalare quali URL devono essere indicizzate, con quale priorità relativa e con quale frequenza di aggiornamento.
Una sitemap efficace include solo URL indexable — nessuna pagina con tag noindex, nessun redirect, nessuna pagina con parametri di tracking. Per i siti grandi, la sitemap va segmentata per tipologia di contenuto (pagine, prodotti, articoli, immagini) per facilitare il monitoraggio in Google Search Console.
Renderizzazione: JavaScript SEO e il problema del rendering lato client
Con la diffusione dei framework JavaScript — React, Vue, Angular, Next.js — il Technical SEO ha dovuto affrontare una sfida nuova: la renderizzazione lato client (Client-Side Rendering, CSR) produce HTML vuoto al momento della richiesta iniziale, con il contenuto generato successivamente via JavaScript.
Questo crea un problema per Google: Googlebot deve eseguire JavaScript per vedere il contenuto della pagina. Google dichiara di essere in grado di farlo, ma con alcune limitazioni: le risorse JavaScript vengono accodate in un secondo momento, il rendering può richiedere giorni, e i contenuti dinamici complessi possono non essere indicizzati correttamente.
Le strategie di rendering
Server-Side Rendering (SSR): il contenuto HTML viene generato sul server e inviato completamente formato al browser. È la modalità più sicura per il SEO — Googlebot riceve HTML completo senza dover eseguire JavaScript.
Static Site Generation (SSG): le pagine vengono pre-generate come file HTML statici al momento del build. Velocità massima, ottimo per il crawl, ideale per contenuti che cambiano raramente.
Incremental Static Regeneration (ISR): ibrido tra SSR e SSG — le pagine statiche vengono rigenerate in background quando il contenuto cambia, combinando velocità e freschezza.
Dynamic Rendering: una soluzione di compromesso in cui si serve HTML pre-renderizzato ai crawler e JavaScript agli utenti umani. Google la considera una tecnica accettabile ma non ideale — il rischio di cloaking percepito è reale se non implementata correttamente.
Il framework Next.js è oggi la scelta più diffusa per i siti che necessitano sia di performance elevata che di indicizzabilità ottimale — combina SSR, SSG e ISR con un’API unificata.
Struttura degli URL: segnali semantici nell’architettura
Gli URL non sono neutri. Comunicano a Google e agli utenti la struttura semantica del sito, la gerarchia dei contenuti e la relazione tra le pagine.
Un URL come /servizi/seo/local-seo-bari/ dice molto più di /page?id=4823:
- La parola “servizi” colloca la pagina nella sezione commerciale del sito
- “seo” identifica la macro-categoria
- “local-seo-bari” specifica il servizio e l’area geografica
Le regole per una struttura URL ottimale:
Kebab-case con trattini: Google interpreta i trattini come separatori di parole; i trattini bassi uniscono le parole in un’unica stringa.
Lowercase obbligatorio: URL maiuscole e minuscole sono URL diverse per il server — un mix non gestito correttamente genera duplicate content.
Lunghezza contenuta: URL brevi e descrittive sono preferibili a URL lunghe con molti parametri. Non esiste un limite fisso, ma oltre 100 caratteri la leggibilità e la condivisibilità si riducono significativamente.
Gerarchia semantica: la struttura dell’URL deve riflettere la struttura del sito — non per convenzione, ma perché Google legge la profondità dell’URL come segnale della gerarchia tematica.
Evitare parametri non necessari: i parametri di sessione, i parametri di tracciamento UTM, i parametri di ordinamento generano URL duplicate che diluiscono l’autorità della pagina canonica.
Canonical tag: gestire il duplicate content con precisione
Il tag canonical (<link rel="canonical" href="URL">) è la dichiarazione con cui si dice a Google quale versione di una pagina è quella principale da indicizzare e a cui attribuire l’autorità.
Il duplicate content — contenuto identico o molto simile su URL diverse — è uno dei problemi tecnici più diffusi, generato da cause diverse:
- Versioni http e https della stessa pagina
- Versioni www e non-www
- URL con e senza slash finale
- Pagine di categoria con paginazione
- Pagine prodotto con varianti (colori, taglie) che generano URL separate
- Contenuto sindicato su più domini
Il canonical non è una soluzione universale: Google lo considera un “segnale forte” ma non vincolante. Se ci sono contraddizioni tra il canonical dichiarato e altri segnali (link interni che puntano alla versione non canonica, sitemap che include la versione duplicata), Google può ignorare il canonical.
Una gestione corretta del canonical richiede coerenza su tutti i livelli: il canonical deve essere supportato da link interni che puntano esclusivamente alla versione canonica, dalla sitemap che include solo le URL canoniche e dai redirect che gestiscono le versioni non canoniche.
HTTPS e sicurezza: il prerequisito invisibile
Dal 2014 Google ha dichiarato HTTPS come segnale di ranking. Non è un fattore determinante in senso assoluto — non porta un sito dalla quinta alla prima posizione — ma è un prerequisito che influenza la fiducia degli utenti e il trattamento preferenziale da parte del browser.
Un sito HTTP nel 2025 mostra al browser Chrome l’avviso “Non sicuro” nella barra degli indirizzi — un segnale di sfiducia che aumenta il bounce rate e riduce le conversioni indipendentemente dalla qualità del contenuto.
La migrazione da HTTP a HTTPS richiede attenzione a tre aspetti critici:
Redirect 301 corretti: ogni URL HTTP deve redirigere verso la corrispondente URL HTTPS con un redirect permanente. Redirect a catena (HTTP → HTTP www → HTTPS) vanno eliminati.
Mixed content: risorse caricate in HTTP su una pagina HTTPS (immagini, script, fogli di stile) generano avvisi del browser e possono bloccare il caricamento delle risorse. Audit sistematico con Screaming Frog o Chrome DevTools per identificare e correggere ogni risorsa mista.
Aggiornamento delle proprietà in Search Console: dopo la migrazione, la proprietà HTTPS va aggiunta e verificata separatamente in Google Search Console — i dati non sono unificati automaticamente.
Mobile-first indexing: il desktop è diventato secondario
Dal 2019 Google ha adottato il mobile-first indexing come default: la versione mobile del sito è quella che Google crawla, indicizza e usa per il ranking — anche per le ricerche da desktop.
Le implicazioni pratiche sono più profonde di quanto sembri:
Parità di contenuto: se la versione mobile del sito mostra meno contenuto di quella desktop — testi abbreviati, immagini mancanti, sezioni nascoste — Google indicizza la versione ridotta. Il contenuto non presente nella versione mobile non contribuisce al posizionamento.
Struttura dati coerente: il markup Schema deve essere presente nella versione mobile con la stessa completezza della versione desktop.
Velocità mobile come priorità: i Core Web Vitals vengono misurati sul dispositivo mobile. Un sito veloce su desktop ma lento su mobile ha Core Web Vitals scadenti — perché quelli che contano sono quelli mobile.
Viewport e responsive design: il tag <meta name="viewport" content="width=device-width, initial-scale=1"> è il prerequisito tecnico per il responsive design. Senza di esso, il browser mobile renderizza la pagina come se fosse desktop, riducendo il testo a dimensioni illeggibili.
Structured data e rich result: il Technical SEO che cambia la SERP
I dati strutturati — implementati in formato JSON-LD secondo le specifiche Schema.org — sono il layer tecnico che trasforma una pagina web in una fonte di dati interpretabile direttamente da Google.
Come abbiamo approfondito nell’articolo su come il Knowledge Graph e l’Entity SEO costruiscono autorità riconoscibile da Google, il markup strutturato è fondamentale per l’identità dell’entità. A livello di Technical SEO, ha una seconda funzione altrettanto preziosa: abilitare i rich result nelle SERP.
I rich result sono risultati di ricerca arricchiti con informazioni aggiuntive estratte dal markup: stelle di valutazione, fasce di prezzo, disponibilità, scadenza delle offerte, domande e risposte, step di ricette, breadcrumb di navigazione. Questi elementi aumentano il CTR anche a parità di posizione — una pagina in quinta posizione con rich result può superare in click una pagina in terza senza markup.
I tipi di markup con il maggiore impatto sulla visibilità SERP:
FAQ e HowTo: generano rich result con domande e risposte direttamente visibili nella SERP, aumentando significativamente lo spazio occupato dal risultato.
Product: abilita la visualizzazione di prezzo, disponibilità e valutazione nei risultati di ricerca per e-commerce.
Review e AggregateRating: le stelle sono il rich result con il maggiore impatto empiricamente documentato sul CTR.
BreadcrumbList: sostituisce l’URL con il percorso di navigazione nel risultato di ricerca, migliorando la leggibilità e comunicando la struttura del sito.
SiteLinksSearchBox: abilita la casella di ricerca interna direttamente nel risultato per brand riconosciuti.
Audit tecnico: il processo sistematico di identificazione e risoluzione dei problemi
Un Technical SEO audit non è una checklist da completare una volta. È un processo periodico — almeno trimestrale — che identifica i problemi tecnici che si accumulano nel tempo: pagine rotte, redirect a catena, tag canonical errati, markup non valido, risorse bloccate.
Gli strumenti dell’audit tecnico
Google Search Console: la fonte più diretta e affidabile per i problemi tecnici rilevati da Google. Le sezioni Copertura, Esperienza delle pagine, Core Web Vitals, Dati strutturati, Sitemap forniscono il quadro completo di come Google vede il sito.
Screaming Frog SEO Spider: il crawler desktop che replica il comportamento di Googlebot sul sito. Identifica link rotti, redirect, tag mancanti, contenuto duplicato, problemi di canonical, errori nei dati strutturati — su tutti gli URL del sito in modo sistematico.
Google PageSpeed Insights: analisi delle performance e dei Core Web Vitals sia su dati di laboratorio (simulazione) che su dati di campo (CrUX — Chrome User Experience Report, dati reali degli utenti Chrome).
Chrome DevTools: il pannello Performance e il Network tab per analisi dettagliate del rendering e del caricamento delle risorse a livello di singola pagina.
Lighthouse: lo strumento integrato in Chrome DevTools per audit completi di performance, accessibilità, best practice SEO e conformità PWA.
Ahrefs Site Audit / Semrush Site Audit: crawler cloud-based con report automatizzati e monitoraggio continuativo dei problemi tecnici.
Il processo dell’audit
Crawl completo del sito: si parte da un crawl completo con Screaming Frog configurato per rispettare il robots.txt e simulare Googlebot. Il crawl produce l’inventario completo di URL, stati HTTP, tag, link, risorse.
Analisi dei dati GSC: si affianca al crawl i dati di Google Search Console — errori di indicizzazione, problemi di usabilità mobile, Core Web Vitals per URL specifiche, warning sui dati strutturati.
Prioritizzazione per impatto: non tutti i problemi tecnici hanno la stessa urgenza. Si prioritizzano per impatto sul ranking e sul crawl: errori 4xx su pagine con backlink, redirect a catena su URL importanti, tag canonical errati su pagine commerciali.
Piano di risoluzione e monitoraggio: ogni problema identificato va tracciato con priorità, responsabile e timeline. Dopo la risoluzione, si monitora in GSC la conferma che Google ha recepito la correzione.
Velocità come differenziale competitivo: il caso delle piattaforme chiuse
C’è una ragione per cui i siti costruiti su certi page builder SaaS e CMS proprietari chiusi faticano a raggiungere Core Web Vitals buoni: non è mancanza di ottimizzazione — è mancanza di controllo.
Questi sistemi generano HTML con dipendenze JavaScript e CSS difficilmente eliminabili, caricano risorse da CDN di terze parti non ottimizzabili, usano strutture di markup che non permettono l’estrazione del CSS critico e spesso non supportano formati immagine moderni o lazy loading nativo.
Chi ha il controllo del codice — che lavora su CMS open source come WordPress con architettura headless, su framework come Next.js o su soluzioni custom — può intervenire su ogni layer della performance:
Eliminazione del render-blocking JavaScript: identificare ed eliminare o differire ogni script non necessario al rendering iniziale.
Estrazione e inlining del critical CSS: automatizzabile con tool come Critical o con la funzionalità di alcuni build tool.
Ottimizzazione delle immagini nella pipeline di build: conversione automatica in WebP/AVIF, generazione di varianti responsive, compressione senza perdita di qualità visiva.
Implementazione della CDN con edge caching: servire le risorse statiche dal nodo CDN geograficamente più vicino all’utente, riducendo la latenza di rete.
HTTP/2 e HTTP/3: i protocolli moderni permettono il multiplexing delle richieste — più risorse caricate simultaneamente su una singola connessione, riducendo la latenza complessiva.
Questa è esattamente la filosofia che la mappa completa delle undici regole per costruire visibilità organica indipendente dalle piattaforme a pagamento applica al Technical SEO: chi affitta la tecnologia negozia le performance; chi la possiede le impone.
Log file analysis: vedere il sito attraverso gli occhi di Google
L’analisi dei file di log del server è uno degli strumenti Technical SEO più potenti e meno utilizzati. I log registrano ogni richiesta ricevuta dal server — incluse quelle di Googlebot — con URL richiesta, codice di risposta, timestamp e user agent.
Analizzare i log di Googlebot permette di rispondere a domande che nessun altro strumento può rispondere direttamente:
- Quali pagine Google crawla più frequentemente?
- Quali pagine non vengono mai crawlate nonostante siano nella sitemap?
- Qual è il TTFB reale misurato dal crawler?
- Ci sono URL non presenti nella sitemap che Google trova e crawla attraverso i link?
- I redirect vengono seguiti correttamente o ci sono loop?
La discrepanza tra le pagine che si vuole che Google crawli e quelle che Google crawla effettivamente è spesso la fonte di problemi di indicizzazione apparentemente inspiegabili. L’analisi dei log li rende visibili e risolvibili.
Core Web Vitals nei dati di campo vs. dati di laboratorio: la distinzione critica
Un’ultima distinzione tecnica che spesso genera confusione: i Core Web Vitals possono essere misurati in due modi fondamentalmente diversi.
Dati di laboratorio (Lab data): simulazione controllata delle performance in condizioni standardizzate. Strumenti come Lighthouse e PageSpeed Insights producono dati di laboratorio. Sono riproducibili, utili per diagnosticare problemi specifici e testare l’impatto delle ottimizzazioni.
Dati di campo (Field data): dati reali raccolti dagli utenti Chrome attraverso il Chrome User Experience Report (CrUX). Riflettono la variabilità reale — dispositivi diversi, connessioni diverse, condizioni di rete diverse. Google usa i dati di campo per il ranking, non quelli di laboratorio.
La divergenza tra i due è frequente: un sito può avere LCP eccellente nei dati di laboratorio ma scarso nei dati di campo perché la maggior parte degli utenti reali accede da dispositivi mobile a connessione 4G in aree con copertura instabile.
L’ottimizzazione deve puntare ai dati di campo — ma i dati di laboratorio sono lo strumento diagnostico per capire dove intervenire. I dati di laboratorio dicono cosa ottimizzare; i dati di campo dicono se l’ottimizzazione ha funzionato nella realtà.
Conclusione: il Technical SEO è il sistema nervoso della presenza organica
Ogni strategia di contenuto, ogni campagna di link building, ogni lavoro di Entity SEO riposa su fondamenta tecniche. Se quelle fondamenta sono fragili — sito lento, crawl budget sprecato, JavaScript non renderizzato, Core Web Vitals scadenti — l’edificio sopra non raggiunge mai la sua altezza potenziale.
Il Technical SEO avanzato non è la parte glamour della SEO. Non produce articoli virali né backlink da testate autorevoli. Produce qualcosa di più prezioso: la certezza che ogni altro investimento sulla presenza organica funzioni alla massima efficienza.
Un sito tecnicamente solido è un sito che Google riesce a scansionare completamente, a renderizzare correttamente, a valutare con precisione e a mostrare con fiducia. È il prerequisito silenzioso di tutto il resto.
Chi lo trascura costruisce su sabbia. Chi lo padroneggia costruisce su roccia.